Usar uma API compatível com múltiplos modelos parece, à primeira vista, uma simples decisão de conveniência: escolhe-se o modelo, envia-se o prompt e recebe-se a resposta. Em um protótipo, isso pode ser suficiente. Em produção, porém, essa abstração esconde uma parte relevante da infraestrutura. O mesmo modelo pode ser executado por provedores diferentes, com hardware, quantização, preço, disponibilidade, latência e políticas de retenção de dados distintas. Se a aplicação não controla essas variáveis, a promessa de flexibilidade pode se transformar em comportamento imprevisível.
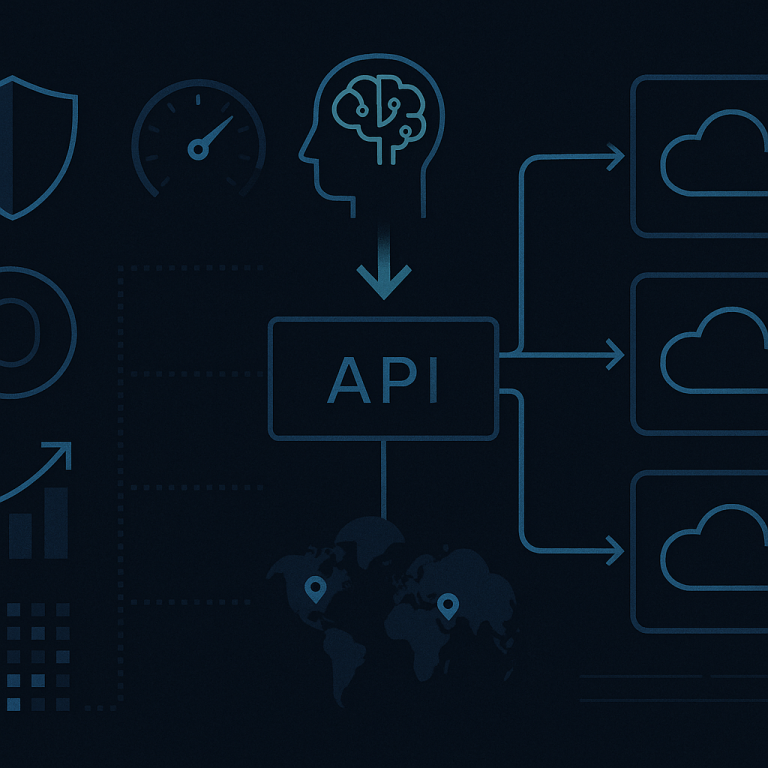
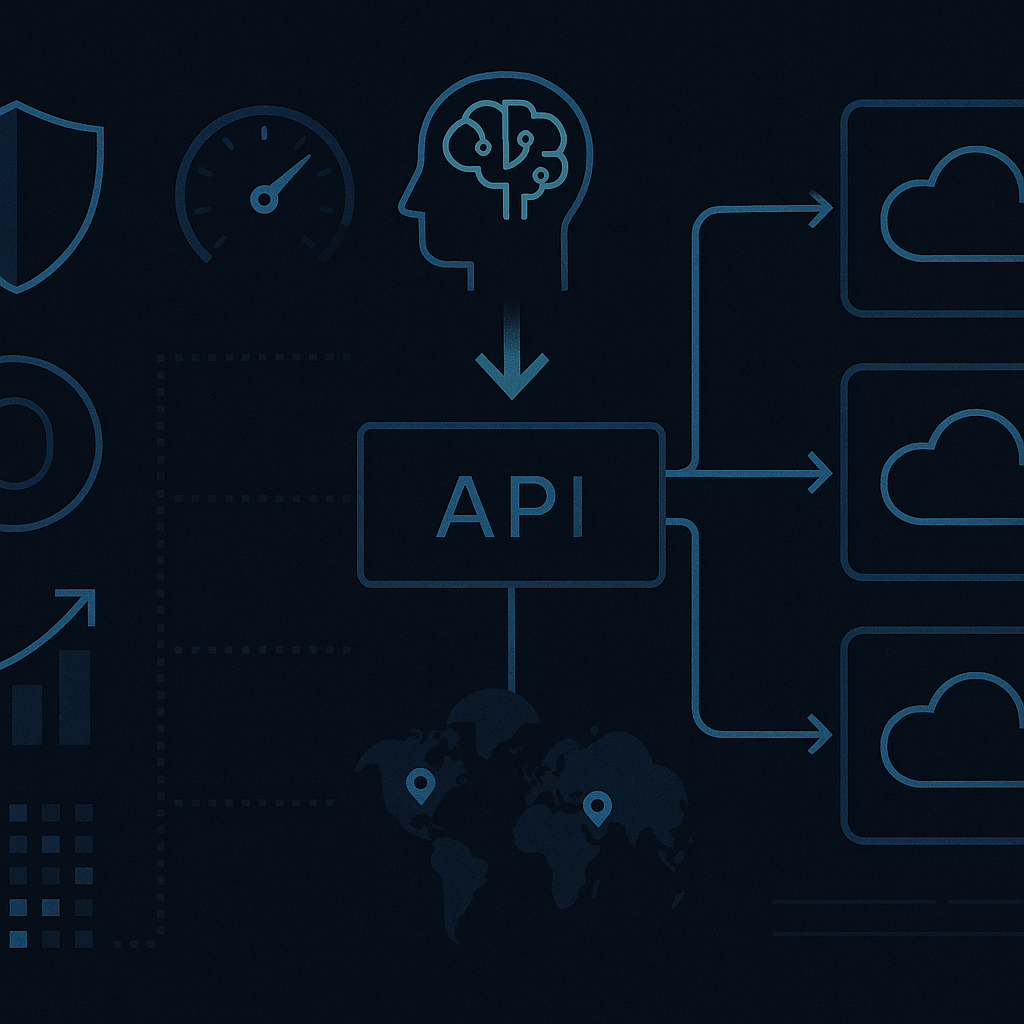
O OpenRouter é uma camada de roteamento que oferece acesso unificado a modelos de diferentes empresas e infraestruturas. Seu valor não está apenas em concentrar APIs. A vantagem estratégica está na possibilidade de selecionar, filtrar e ordenar os provedores aptos a processar cada requisição. Esse recurso permite construir uma arquitetura com redundância sem abandonar requisitos mínimos de segurança, desempenho e governança.
A tese central é direta: em ambiente produtivo, não basta escolher o modelo. É necessário governar também o endpoint que efetivamente executará a inferência.
O modelo não é toda a infraestrutura
Quando uma aplicação solicita determinado modelo por meio de um agregador, pode existir mais de um endpoint capaz de atendê-la. Embora todos anunciem compatibilidade com o mesmo modelo, os resultados operacionais não são necessariamente equivalentes. Um provedor pode executar pesos em maior precisão; outro pode adotar quantização mais agressiva para reduzir custo e aumentar velocidade. Um pode manter baixa latência na Europa, enquanto outro apresenta melhor desempenho nas Américas. Também podem existir diferenças contratuais sobre armazenamento de prompts, respostas e metadados.
Isso significa que o identificador do modelo é apenas uma parte da configuração. Para aplicações corporativas, a unidade real de avaliação deveria ser a combinação entre modelo, provedor, endpoint, região, quantização e política de dados.
Ignorar essa composição cria quatro riscos principais:
- variação silenciosa na qualidade das respostas;
- oscilações de latência e throughput que afetam a experiência do usuário;
- mudanças inesperadas de custo;
- processamento de informações por uma infraestrutura incompatível com as regras internas ou contratuais.
O problema não é exclusivo do OpenRouter. Ele existe em qualquer arquitetura multicloud ou multiprovedor. A diferença é que uma boa camada de roteamento oferece controles para administrar essa complexidade, em vez de apenas escondê-la.
Preço é filtro, não estratégia
Escolher sempre a rota mais barata pode ser racional em experimentos descartáveis, mas raramente é uma política adequada para produção. O custo por token é fácil de comparar porque aparece de forma explícita. Qualidade, estabilidade e risco regulatório são mais difíceis de quantificar, embora possam custar muito mais quando falham.
Uma resposta barata que exige nova geração, revisão humana ou retrabalho não é realmente barata. Da mesma forma, economizar alguns centavos em inferência não compensa uma indisponibilidade durante uma operação crítica. O cálculo de custo deve considerar a transação completa: inferência, repetição, monitoramento, suporte, impacto da latência e custo potencial de incidentes.
O preço continua relevante, mas deve ser aplicado depois dos requisitos eliminatórios. Primeiro, a organização define quais provedores são aceitáveis. Depois, entre os aprovados, utiliza preço ou desempenho para ordenar as rotas.
Quantização e a qualidade que não aparece no nome
Quantização é a técnica de representar os pesos e, em alguns casos, outras partes do cálculo do modelo com menor precisão numérica. Formatos de menor precisão reduzem memória e podem aumentar a velocidade, permitindo executar modelos grandes em infraestrutura mais econômica. Em contrapartida, quantizações agressivas podem produzir perda de qualidade, especialmente em tarefas sensíveis a raciocínio, código, cálculos, contexto extenso ou aderência rigorosa a instruções.
Rótulos como FP16, FP8, INT8 ou variantes de quatro bits não devem ser lidos apenas como especificações de hardware. Eles representam uma decisão de engenharia com efeitos sobre custo, throughput e fidelidade. Além disso, duas implementações com precisão nominal semelhante podem apresentar resultados diferentes por causa do método de quantização, do runtime e da configuração de serving.
A recomendação profissional é estabelecer um conjunto de testes representativo do uso real. Um benchmark genérico não substitui uma avaliação com prompts, idiomas, documentos e critérios do próprio negócio. Para um assistente jurídico, por exemplo, a métrica deve incluir fidelidade à fonte, preservação de ressalvas e taxa de alucinação. Em geração de código, devem ser medidos compilação, testes automatizados e vulnerabilidades. Em atendimento, importam aderência ao tom, resolução e escalonamento correto.
Depois dessa validação, a aplicação pode restringir as quantizações aceitas no roteamento. Assim, uma mudança de disponibilidade não empurra silenciosamente a carga para um endpoint abaixo do padrão de qualidade aprovado.
Latência e throughput medem coisas diferentes
Latência é o tempo percebido até o início ou a conclusão da resposta. Em interfaces conversacionais com streaming, o tempo até o primeiro token costuma ser decisivo para a sensação de agilidade. Throughput é a velocidade de geração, geralmente medida em tokens por segundo. Um endpoint pode começar rapidamente e gerar devagar; outro pode demorar mais para iniciar e, depois, produzir a resposta em alta velocidade.
A prioridade depende do caso de uso. Chat interativo tende a valorizar tempo até o primeiro token. Processamento em lote, extração e sumarização de documentos extensos podem se beneficiar mais de throughput elevado. Agentes que realizam várias chamadas sequenciais são especialmente sensíveis à latência acumulada: pequenos atrasos em cada etapa tornam-se segundos ou minutos no fluxo completo.
Segundo a documentação do OpenRouter, o roteamento pode ordenar endpoints por latência, throughput ou preço, utilizando métricas recentes dos provedores. Esse recurso é útil, mas não elimina a necessidade de observabilidade própria. A empresa deve registrar pelo menos provedor efetivo, modelo, quantidade de tokens, tempo até o primeiro token, duração total, status, tentativas de fallback e custo estimado.
Médias também são insuficientes. Operações reais devem acompanhar percentis como p50, p95 e p99. Uma latência média aceitável pode esconder uma cauda longa que prejudica parte significativa dos usuários.
Região, disponibilidade e residência de dados
A região de processamento interfere na latência, na resiliência e na governança. Quanto maior a distância entre aplicação, usuário e endpoint de inferência, maior tende a ser o tempo de rede. Além disso, algumas organizações impõem requisitos de residência ou transferência internacional de dados.
Recursos de roteamento regional podem depender do plano contratado e da disponibilidade dos endpoints. Por isso, requisitos geográficos não devem permanecer apenas na documentação de arquitetura. Eles precisam ser convertidos em controles técnicos, cláusulas contratuais e testes periódicos.
Também é importante distinguir disponibilidade do gateway e disponibilidade do provedor final. O OpenRouter pode estar operacional enquanto um endpoint específico sofre limitação, erro ou saturação. É exatamente nesse ponto que o fallback agrega valor, desde que as alternativas tenham sido previamente aprovadas.
Retenção de dados: ZDR não é sinônimo automático de conformidade
Prompts corporativos podem conter dados pessoais, segredos comerciais, código-fonte, documentos internos ou informações de clientes. A política de retenção de cada provedor, portanto, é um requisito de arquitetura, não uma configuração secundária.
O OpenRouter oferece controles relacionados a Zero Data Retention, ou ZDR, e permite restringir o roteamento a endpoints classificados de acordo com políticas de dados. Em termos práticos, a configuração pode impedir o envio a provedores que armazenem o conteúdo após o processamento. A lista de endpoints elegíveis, porém, pode mudar; por isso, a validação precisa ser contínua.
Zero retenção reduz a superfície de risco, mas não comprova sozinho conformidade com a Lei Geral de Proteção de Dados. A LGPD exige uma análise mais ampla: finalidade, necessidade, base legal, transparência, segurança, direitos dos titulares, operadores envolvidos e transferências internacionais. Também é necessário verificar contratos, acordo de tratamento de dados, subprocessadores, resposta a incidentes e condições de exclusão.
Em outras palavras, ZDR é um controle técnico importante, mas não substitui governança jurídica e organizacional. Dados sensíveis devem ser minimizados ou anonimizados antes do envio sempre que possível. Credenciais, tokens e senhas nunca devem integrar prompts.
O pool de provedores aprovados
Fixar um único provedor aumenta previsibilidade, mas elimina parte importante do benefício de um roteador: a continuidade diante de falhas. Na direção oposta, liberar todos os provedores maximiza disponibilidade teórica, mas reduz controle. A solução equilibrada é um pool de endpoints homologados.
Um desenho inicial razoável utiliza pelo menos três provedores que cumpram os mesmos requisitos mínimos. O primeiro pode ser priorizado por qualidade e latência. O segundo oferece capacidade alternativa. O terceiro reduz o risco de falha correlacionada. O número três não é uma regra universal, mas cria redundância suficiente para evitar dependência excessiva sem tornar a governança inadministrável.
A homologação deve considerar:
- qualidade medida com testes do negócio;
- quantizações permitidas;
- latência e throughput por região;
- limites de contexto e funcionalidades suportadas;
- política de retenção e uso para treinamento;
- histórico de disponibilidade;
- preço e previsibilidade financeira;
- termos contratuais e requisitos de segurança.
O fallback deve ocorrer apenas dentro desse conjunto. Se todos os endpoints aprovados estiverem indisponíveis, falhar de modo explícito pode ser mais seguro do que enviar dados a uma infraestrutura desconhecida. Essa é uma decisão de apetite de risco, e não apenas de conveniência técnica.
Controle no payload: política como código
O objeto de configuração de provedor transforma decisões arquiteturais em regras executáveis. Em vez de confiar no comportamento padrão do roteador, a aplicação pode definir uma lista permitida, negar provedores com coleta de dados, selecionar quantizações e ordenar alternativas por desempenho ou preço.
Um exemplo conceitual de payload é:
{
  "model": "modelo-aprovado",
  "messages": [
    {"role": "user", "content": "Conteúdo da solicitação"}
  ],
  "provider": {
    "only": ["provedor-a", "provedor-b", "provedor-c"],
    "allow_fallbacks": true,
    "data_collection": "deny",
    "sort": "latency",
    "quantizations": ["fp16", "fp8"]
  }
}
Os nomes e valores aceitos devem ser confirmados na documentação vigente antes da implantação. O ponto arquitetural é separar requisitos eliminatórios de preferências. A lista de provedores, a política de dados e as quantizações funcionam como restrições. A ordenação por latência, throughput ou preço atua somente sobre os endpoints que sobreviveram a esses filtros.
Quando a aplicação exige comportamento estritamente previsível, pode desativar fallbacks ou determinar uma ordem fixa. Essa escolha, contudo, reduz balanceamento e disponibilidade. Para cargas menos críticas, a ordenação dinâmica pode oferecer melhor aproveitamento da infraestrutura.
Uma arquitetura de referência para produção
Uma implementação madura não deveria espalhar configurações de OpenRouter pelo código de cada funcionalidade. O ideal é manter uma camada interna de acesso a modelos, responsável por autenticação, políticas, observabilidade, limites e fallback. Essa camada recebe a classificação da carga e aplica o perfil correspondente.
Podem existir, por exemplo, três perfis. O perfil restrito aceita apenas endpoints ZDR, uma região definida e quantizações homologadas. O perfil interativo prioriza latência. O perfil em lote prioriza throughput e custo dentro do conjunto aprovado. Dessa forma, a política deixa de depender da memória de cada desenvolvedor.
Também é recomendável implementar:
- versionamento das políticas de roteamento;
- cofre de segredos para chaves de API;
- redação ou tokenização de dados pessoais antes da inferência;
- logs sem conteúdo sensível;
- limites de gasto por aplicação, equipe e usuário;
- circuit breaker para endpoints instáveis;
- testes sintéticos recorrentes de qualidade e desempenho;
- alertas para mudança de provedor, custo ou taxa de erro;
- procedimento de resposta a incidentes;
- revisão periódica dos provedores homologados.
O cabeçalho ou metadado de identificação da aplicação também deve ser configurado conforme as recomendações do serviço, facilitando rastreabilidade operacional. Em ambientes regulados, cada alteração na política precisa gerar trilha de auditoria.
O erro de tratar o roteador como caixa-preta
O maior risco não está em usar um agregador, mas em utilizá-lo sem política explícita. Uma abstração bem governada reduz acoplamento, facilita comparação entre modelos e melhora resiliência. Uma abstração opaca apenas desloca decisões críticas para padrões definidos por terceiros.
Em engenharia de dados, ninguém aceitaria que uma carga de ETL escolhesse aleatoriamente onde armazenar informações sensíveis. Em aplicações de IA, o mesmo rigor deve valer para inferência. O prompt é dado em trânsito; o provedor é parte da cadeia de processamento; e o roteamento é uma decisão de arquitetura.
Conclusão
O OpenRouter pode ser uma camada valiosa para aplicações de IA em produção porque combina acesso unificado, redundância e mecanismos de seleção de provedores. Mas sua flexibilidade precisa ser acompanhada por controles. Escolher apenas o modelo e o menor preço é insuficiente.
Uma estratégia profissional começa com requisitos de qualidade, privacidade, região e disponibilidade. Em seguida, homologa um pool pequeno de provedores, converte as regras em payloads versionados e monitora o endpoint realmente utilizado. O fallback permanece ativo apenas entre alternativas aceitáveis. Métricas próprias verificam se a promessa operacional está sendo cumprida.
A pergunta correta deixa de ser “qual modelo vamos usar?” e passa a ser “qual combinação de modelo, provedor, precisão, região e política de dados atende a esta carga?”. Essa mudança de perspectiva transforma uma integração conveniente em uma infraestrutura de IA governável.
Fontes consultadas
- OpenRouter: Latency and Performance
- OpenRouter: How to Evaluate LLM Provider Performance
- OpenRouter: Zero Data Retention
- OpenRouter: Providers and Retention Policies
- OpenRouter Documentation: Provider Selection
- OpenRouter Documentation: Data Collection
Qual requisito deveria vir primeiro na sua arquitetura de IA: privacidade, qualidade, latência ou custo?